Datenannotation Statistiken 2026: Label-Qualität, Aufwand und EU AI Act

Geprüfte, belegte Zahlen zur Datenannotation: wie oft Labels falsch sind, wie lange Boxen, Masken und Segmentierung dauern, was die Arbeit beschleunigt und was der EU AI Act von Trainingsdaten verlangt.
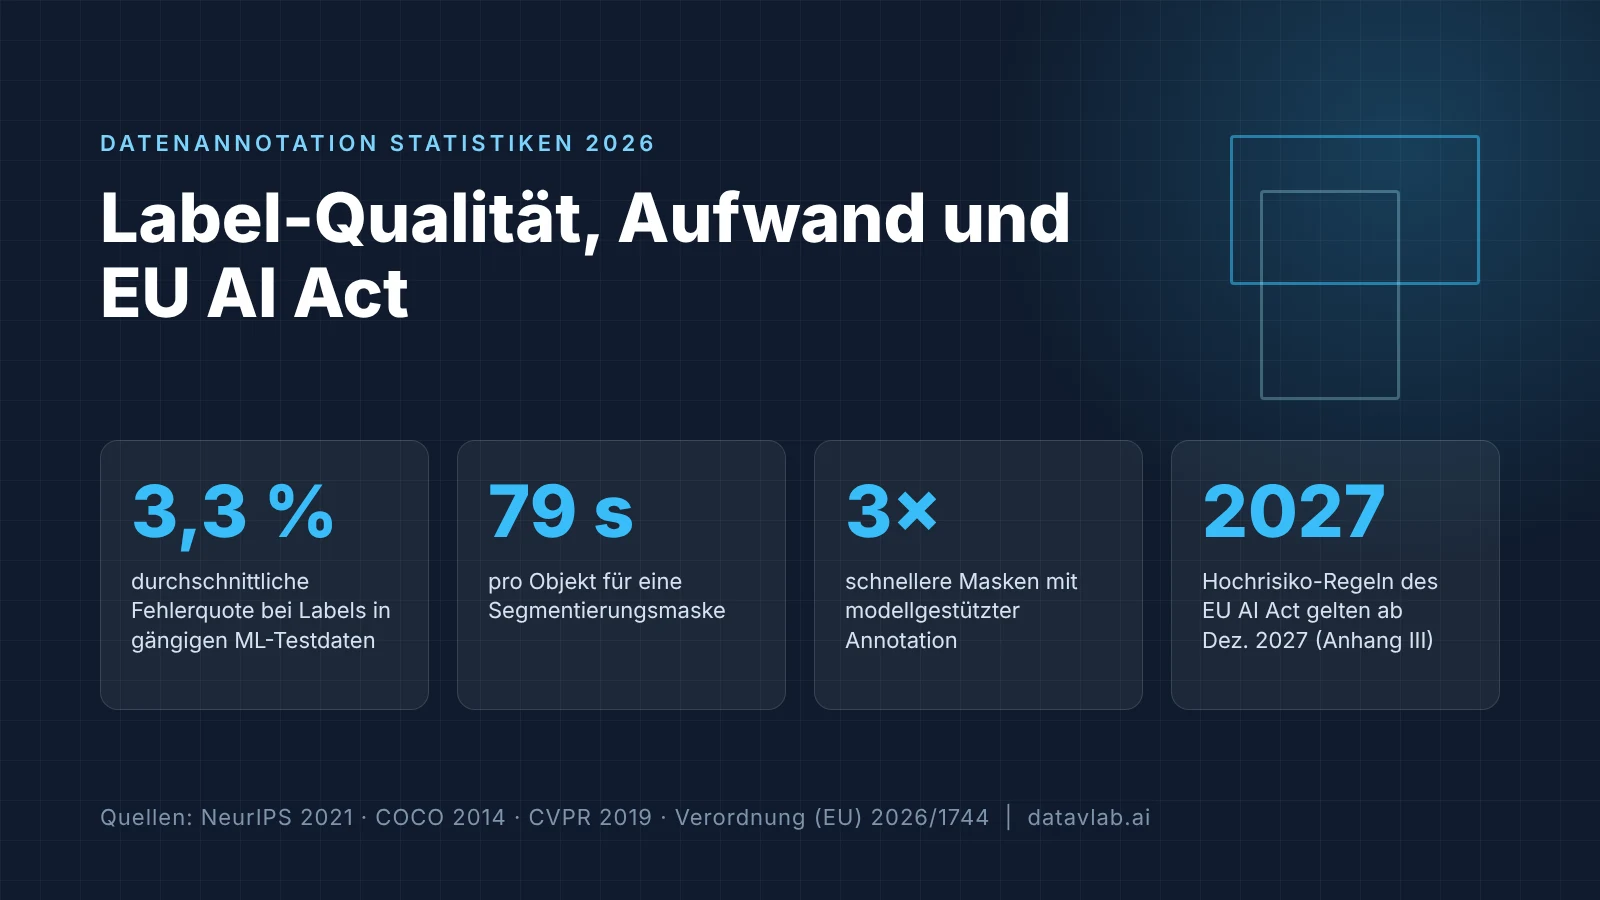
- Im Durchschnitt sind mindestens 3,3 % der Labels in 10 weit verbreiteten ML-Testdatensätzen falsch, und mindestens 6 % des ImageNet-Validierungssets sind falsch gelabelt.
- Eine klassisch gezeichnete Bounding Box dauert etwa 35 Sekunden, eine Instanzsegmentierungsmaske etwa 79 Sekunden und die vollständige pixelgenaue Annotation einer Straßenszene über 1,5 Stunden pro Bild.
- Modellgestützte Segmentierung erzeugt Masken etwa dreimal schneller als manuelles Polygonzeichnen.
- Artikel 10 des EU AI Act verlangt relevante, repräsentative und möglichst fehlerfreie Trainingsdaten; die Hochrisiko-Pflichten gelten ab dem 2. Dezember 2027 (Anhang III) und dem 2. August 2028 (Anhang I).
Diese Seite bündelt geprüfte, belegte Zahlen zur Datenannotation: wie oft Labels falsch sind, wie lange verschiedene Annotationstypen dauern, was die Arbeit beschleunigt und was der EU AI Act inzwischen von Trainingsdaten verlangt. Jede Zahl verweist auf ihre Originalquelle. Es handelt sich um Branchenstatistiken, nicht um Preise von DataVLab.
Label-Fehler sind häufig, selbst in Benchmark-Datensätzen
Im Durchschnitt sind mindestens 3,3 % der Labels in 10 der meistgenutzten Machine-Learning-Testdatensätze falsch. Die Studie umfasst Bild-, Text- und Audiodatensätze.
Mindestens 6 % des ImageNet-Validierungssets sind falsch gelabelt. ImageNet ist einer der meistzitierten Benchmarks im Computer Vision.
Label-Qualität kann entscheiden, welches Modell gewinnt
Auf korrigierten Labels übertrifft ResNet-18 das Modell ResNet-50, sobald der Anteil ursprünglich falsch gelabelter Testbeispiele um nur 6 % steigt. Ein kleineres Modell kann also schlechter wirken als ein größeres, nur weil die Test-Labels verrauscht sind.
Die praktische Folge: Teams, die Modelle auf ungeprüften Testdaten auswählen, können das falsche Modell wählen. Die menschliche Validierung von Evaluationsdaten ist ebenso wichtig wie die von Trainingsdaten.
Quelle: Northcutt et al., NeurIPS 2021.
Wie lange Annotation dauert, nach Typ
Eine hochwertige Bounding Box klassisch zu zeichnen dauert etwa 35 Sekunden. Mit einer optimierten Methode namens „Extreme Clicking“ dauert dieselbe Box etwa 7 Sekunden, also fünfmal schneller (Papadopoulos et al., ICCV 2017).
Eine Instanzsegmentierungsmaske dauert etwa 79 Sekunden pro Objekt. Für den COCO-Datensatz waren über 22 Arbeitsstunden pro 1.000 Segmentierungen nötig (Lin et al., Microsoft COCO, 2014). Das ist mehr als doppelt so lang wie eine klassisch gezeichnete Box und über zehnmal so lang wie eine optimierte.
Die vollständige pixelgenaue Annotation einer Straßenszene dauert über 1,5 Stunden pro Bild, einschließlich Qualitätskontrolle. Die grobe Annotation derselben Szenen dauerte unter 7 Minuten pro Bild, also mehr als zwölfmal weniger (Cordts et al., The Cityscapes Dataset, CVPR 2016).
Für die Projektplanung heißt das: Der Annotationstyp, nicht die Anzahl der Bilder, bestimmt den Aufwand. Dieselben 10.000 Bilder können einige Tage oder mehrere Monate Arbeit bedeuten, je nachdem, ob Boxen, Masken oder eine dichte Segmentierung gebraucht werden. Unser Leitfaden zu Datenannotation-Preisen erklärt, wie sich das auf die Kosten auswirkt.
Wohin die Zeit geht und was sie verkürzt
Datenfachleute verbringen etwa 38 % ihrer Zeit mit Datenaufbereitung und -bereinigung, so eine Umfrage unter 3.493 Teilnehmenden in 133 Ländern (Anaconda, State of Data Science 2022).
Modellgestützte Segmentierung erzeugt Masken etwa dreimal schneller als manuelles Polygonzeichnen: rund 34 Sekunden pro Objekt gegenüber geschätzten 108 Sekunden für Polygone, gemessen an 2,5 Millionen Masken (Benenson, Popov und Ferrari, „Large-scale interactive object segmentation with human annotators“, CVPR 2019). Die Schätzungen für manuelles Polygonzeichnen variieren je nach Studie zwischen etwa 79 und 108 Sekunden pro Objekt, abhängig von der Objektkomplexität.
Deshalb kombinieren moderne Annotations-Pipelines automatische Vorannotation mit menschlicher Korrektur und Validierung: Das Modell übernimmt den ersten Durchgang, und Menschen konzentrieren sich auf Ermessensfragen und auf Fehler, die Modelle übersehen.
Was der EU AI Act von Trainingsdaten verlangt
Artikel 10 der KI-Verordnung (EU AI Act) verlangt, dass Trainings-, Validierungs- und Testdatensätze von Hochrisiko-KI-Systemen „relevant, hinreichend repräsentativ und so weit wie möglich fehlerfrei und im Hinblick auf die Zweckbestimmung vollständig“ sind.
Der Artikel nennt ausdrücklich „Annotation, Kennzeichnung“ unter den Datenaufbereitungsvorgängen, die geeigneten Data-Governance-Verfahren unterliegen müssen. Anbieter müssen Datensätze zudem auf mögliche Verzerrungen (Bias) untersuchen, Maßnahmen zu deren Erkennung, Vermeidung und Abschwächung ergreifen und Datenlücken identifizieren, die der Konformität entgegenstehen.
Quelle: Europäische Kommission, AI Act Service Desk, Artikel 10. Eine praktische Anleitung bietet unsere EU AI Act Compliance-Checkliste für KI-Teams.
Ab wann die Hochrisiko-Pflichten gelten
In Anhang III aufgeführte Hochrisiko-KI-Systeme müssen ab dem 2. Dezember 2027 konform sein. Hochrisiko-KI in Produkten, die unter EU-Produktvorschriften fallen (Anhang I), muss ab dem 2. August 2028 konform sein.
Diese Termine wurden durch den Digital-Omnibus zur KI festgelegt, die Verordnung (EU) 2026/1744, veröffentlicht im Amtsblatt am 24. Juli 2026 und in Kraft seit dem 27. Juli 2026. Sie ersetzen die ursprünglichen Fristen August 2026 und August 2027. Teams, die Hochrisiko-Systeme entwickeln, haben damit ein klares Zeitfenster, um konforme Datenprozesse einzuführen, einschließlich dokumentierter Annotation und Qualitätskontrolle.
Quelle: Zusammenfassung zur Veröffentlichung der Verordnung (EU) 2026/1744; Hintergrund zur Einigung: Gibson Dunn.
So zitieren Sie diese Seite
Sie dürfen jede Zahl auf dieser Seite verwenden. Bitte nennen Sie die jeweils verlinkte Originalquelle und diese Seite wie folgt: DataVLab, „Datenannotation Statistiken 2026“, https://datavlab.ai/de/post/datenannotation-statistiken.
Aus diesen Zahlen einen verlässlichen Datensatz machen
DataVLab bietet Datenannotationsdienste für Teams in regulierten Branchen und kombiniert automatische Vorannotation mit fachkundiger menschlicher Validierung. Wir sind nach ISO 27001 zertifiziert sowie DSGVO- und HIPAA-konform. Für die Grundlagen lesen Sie Was ist Datenannotation?, oder kontaktieren Sie uns, um Ihr Projekt zu besprechen.
Wie häufig sind Label-Fehler in Machine-Learning-Datensätzen?
Eine NeurIPS-2021-Studie von Northcutt et al. schätzt im Durchschnitt mindestens 3,3 % Label-Fehler in 10 weit verbreiteten Testdatensätzen; mindestens 6 % des ImageNet-Validierungssets sind falsch gelabelt.
Wie lange dauert das Zeichnen einer Bounding Box?
Etwa 35 Sekunden für eine hochwertige, klassisch gezeichnete Box und etwa 7 Sekunden mit der Methode „Extreme Clicking“ (Papadopoulos et al., ICCV 2017).
Wie lange dauert Segmentierungsannotation?
Eine Instanzsegmentierungsmaske dauert laut COCO etwa 79 Sekunden pro Objekt (über 22 Arbeitsstunden pro 1.000 Masken). Die vollständige pixelgenaue Annotation einer komplexen Straßenszene dauerte bei Cityscapes über 1,5 Stunden pro Bild.
Beschleunigt Vorannotation das Labeling?
Ja. Modellgestützte Segmentierung erzeugte in einer Studie mit 2,5 Millionen Masken etwa dreimal schneller Masken als manuelles Polygonzeichnen (Benenson et al., CVPR 2019). Eine menschliche Prüfung bleibt nötig, um Modellfehler zu korrigieren.
Was sagt der EU AI Act zur Annotation von Trainingsdaten?
Artikel 10 verlangt, dass Datensätze von Hochrisiko-KI-Systemen relevant, hinreichend repräsentativ und so weit wie möglich fehlerfrei und vollständig sind. Annotation und Kennzeichnung werden ausdrücklich als Datenaufbereitungsvorgänge genannt, die einer geeigneten Governance unterliegen.
Ab wann gelten die Hochrisiko-Pflichten des EU AI Act?
Ab dem 2. Dezember 2027 für Hochrisiko-Systeme nach Anhang III und ab dem 2. August 2028 für Systeme nach Anhang I, gemäß dem Digital-Omnibus zur KI (Verordnung (EU) 2026/1744).