Estadísticas de anotación de datos 2026: calidad de etiquetas, esfuerzo y Ley de IA de la UE

Cifras verificadas y con fuentes sobre la anotación de datos: con qué frecuencia las etiquetas son erróneas, cuánto tardan cajas, máscaras y segmentación, qué acelera el trabajo y qué exige la Ley de IA de la UE a los datos de entrenamiento.
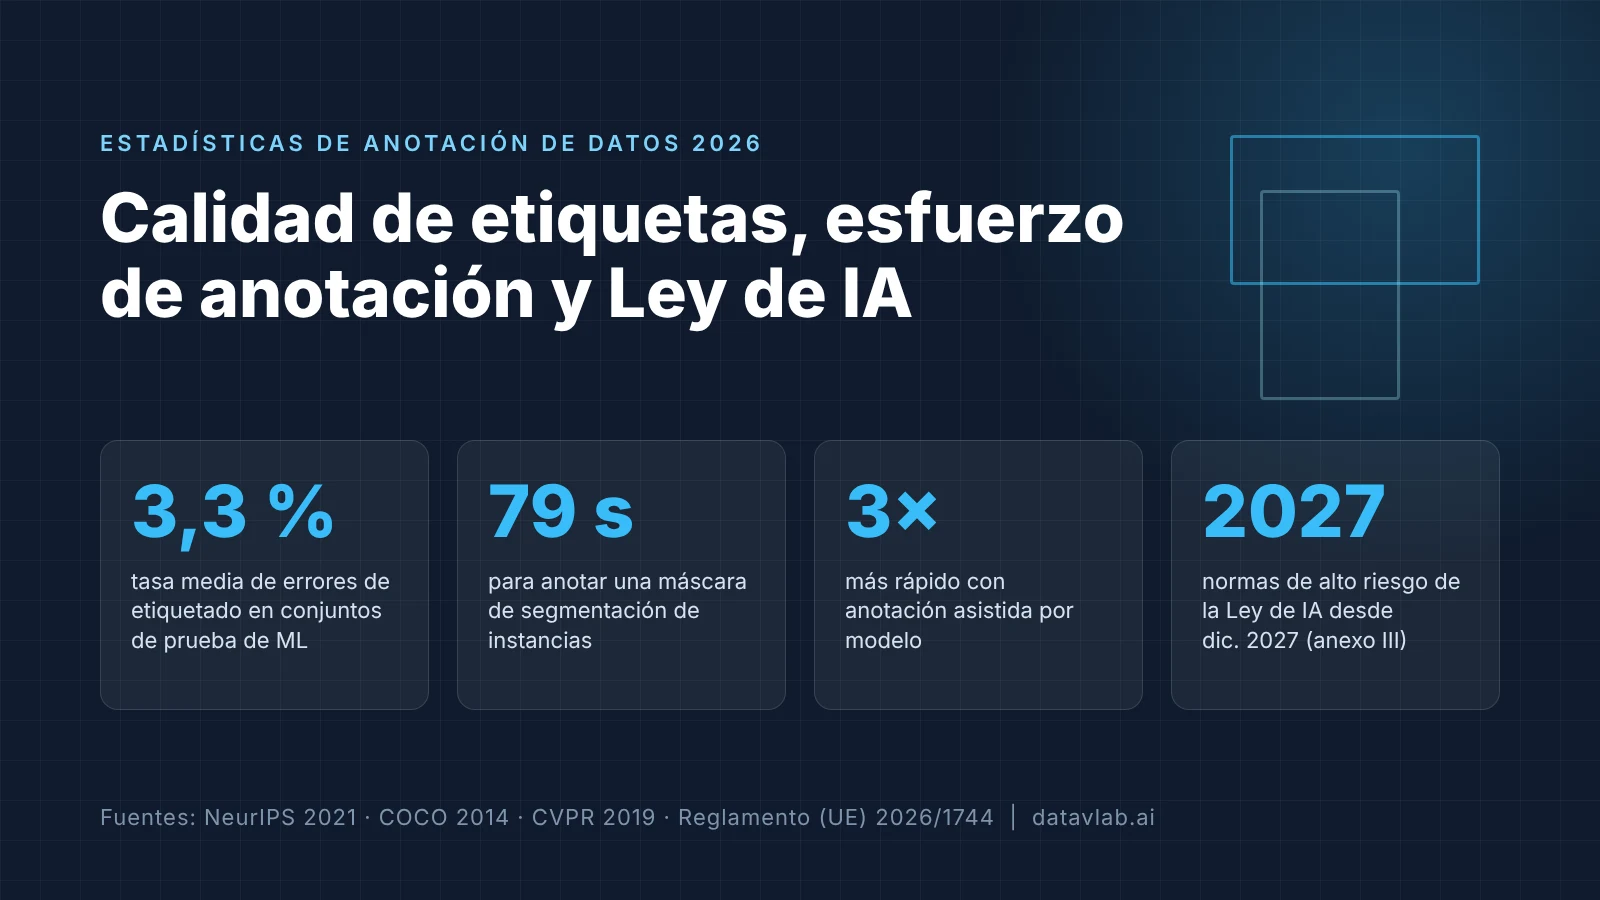
- De media, al menos el 3,3 % de las etiquetas son erróneas en 10 conjuntos de prueba de machine learning muy utilizados, y al menos el 6 % del conjunto de validación de ImageNet está mal etiquetado.
- Una caja delimitadora tradicional lleva unos 35 segundos, una máscara de segmentación de instancias unos 79 segundos y la anotación completa a nivel de píxel de una escena urbana más de 1,5 horas por imagen.
- La segmentación asistida por modelo produce máscaras unas 3 veces más rápido que el trazado manual de polígonos.
- El artículo 10 de la Ley de IA exige datos de entrenamiento pertinentes, representativos y, en la mayor medida posible, sin errores; las obligaciones de alto riesgo se aplican desde el 2 de diciembre de 2027 (anexo III) y el 2 de agosto de 2028 (anexo I).
Esta página reúne cifras verificadas y con fuentes sobre la anotación de datos: con qué frecuencia las etiquetas son erróneas, cuánto tardan los distintos tipos de anotación, qué acelera el trabajo y qué exige ahora la Ley de IA de la UE a los datos de entrenamiento. Cada cifra enlaza a su fuente original. Son estadísticas del sector, no tarifas de DataVLab.
Los errores de etiquetado son frecuentes, incluso en conjuntos de referencia
De media, al menos el 3,3 % de las etiquetas son erróneas en 10 de los conjuntos de prueba de machine learning más utilizados. El estudio abarca conjuntos de imagen, texto y audio.
Al menos el 6 % del conjunto de validación de ImageNet está mal etiquetado. ImageNet es uno de los benchmarks más citados en visión por computador.
La calidad de las etiquetas puede cambiar qué modelo gana
Con etiquetas corregidas, ResNet-18 supera a ResNet-50 en cuanto la proporción de ejemplos de prueba originalmente mal etiquetados aumenta solo un 6 %. Es decir, un modelo más pequeño puede parecer peor que uno más grande solo porque las etiquetas de prueba tienen ruido.
La consecuencia práctica: los equipos que eligen modelos con datos de prueba sin validar pueden elegir el equivocado. La validación humana de los conjuntos de evaluación importa tanto como la de los datos de entrenamiento.
Fuente: Northcutt et al., NeurIPS 2021.
Cuánto tarda la anotación, según el tipo
Trazar una caja delimitadora de calidad con el método tradicional lleva unos 35 segundos. Con un método optimizado llamado «extreme clicking», la misma caja lleva unos 7 segundos, cinco veces más rápido (Papadopoulos et al., ICCV 2017).
Una máscara de segmentación de instancias lleva unos 79 segundos por objeto. La creación del conjunto COCO requirió más de 22 horas de trabajo por cada 1.000 segmentaciones (Lin et al., Microsoft COCO, 2014). Es más del doble que una caja trazada de forma tradicional y más de diez veces una optimizada.
La anotación completa a nivel de píxel de una escena urbana lleva más de 1,5 horas por imagen, incluido el control de calidad. La anotación aproximada de las mismas escenas llevó menos de 7 minutos por imagen, más de 12 veces menos (Cordts et al., The Cityscapes Dataset, CVPR 2016).
La conclusión para planificar un proyecto: es el tipo de anotación, no el número de imágenes, lo que determina el esfuerzo. Las mismas 10.000 imágenes pueden suponer unos días o varios meses de trabajo según necesiten cajas, máscaras o segmentación densa. Nuestra guía de precios de anotación de datos explica cómo se traduce esto en coste.
A dónde va el tiempo y qué lo acelera
Los profesionales de datos dedican alrededor del 38 % de su tiempo a la preparación y limpieza de datos, según una encuesta a 3.493 personas en 133 países (Anaconda, State of Data Science 2022).
La segmentación asistida por modelo produce máscaras unas 3 veces más rápido que el trazado manual de polígonos: unos 34 segundos por objeto frente a unos 108 segundos estimados para polígonos, medido sobre 2,5 millones de máscaras (Benenson, Popov y Ferrari, «Large-scale interactive object segmentation with human annotators», CVPR 2019). Las estimaciones del tiempo de trazado manual varían entre estudios, de unos 79 a 108 segundos por objeto, según la complejidad de los objetos.
Por eso los flujos de anotación modernos combinan preanotación automática con corrección y validación humanas: el modelo hace la primera pasada y las personas se centran en los casos que requieren criterio y en los errores que los modelos no detectan.
Qué exige la Ley de IA de la UE a los datos de entrenamiento
El artículo 10 del Reglamento de IA de la UE exige que los conjuntos de datos de entrenamiento, validación y prueba de los sistemas de IA de alto riesgo sean pertinentes y suficientemente representativos y, en la mayor medida posible, estén libres de errores y completos en vista de su finalidad prevista.
El artículo menciona expresamente «la anotación, el etiquetado» entre las operaciones de preparación de datos que deben estar sujetas a prácticas adecuadas de gobernanza. Los proveedores deben además examinar los conjuntos de datos para detectar posibles sesgos, adoptar medidas para detectarlos, prevenirlos y mitigarlos, e identificar las lagunas de datos que impiden el cumplimiento.
Fuente: Comisión Europea, AI Act Service Desk, artículo 10. Para una guía práctica, consulte nuestra checklist de cumplimiento de la Ley de IA.
Cuándo se aplican las obligaciones de alto riesgo
Los sistemas de IA de alto riesgo del anexo III deben cumplir a partir del 2 de diciembre de 2027. La IA de alto riesgo integrada en productos cubiertos por la legislación de producto de la UE (anexo I) debe cumplir a partir del 2 de agosto de 2028.
Estas fechas las fijó el Ómnibus Digital sobre IA, el Reglamento (UE) 2026/1744, publicado en el Diario Oficial el 24 de julio de 2026 y en vigor desde el 27 de julio de 2026. Sustituyen a los plazos originales de agosto de 2026 y agosto de 2027. Los equipos que desarrollan sistemas de alto riesgo disponen ahora de un margen definido para implantar prácticas de datos conformes, incluida una anotación y un control de calidad documentados.
Fuente: resumen de la publicación del Reglamento (UE) 2026/1744; contexto del acuerdo: Gibson Dunn.
Cómo citar esta página
Puede utilizar cualquier cifra de esta página. Cite la fuente original enlazada junto a ella y esta página así: DataVLab, «Estadísticas de anotación de datos 2026», https://datavlab.ai/es/post/estadisticas-anotacion-datos.
Convertir estas cifras en un conjunto de datos fiable
DataVLab ofrece servicios de anotación de datos para equipos de sectores regulados, combinando preanotación automática con validación humana experta. Contamos con la certificación ISO 27001 y cumplimos el RGPD y HIPAA. Para repasar los conceptos básicos, lea ¿Qué es la anotación de datos?, o contáctenos para hablar de su proyecto.
¿Son frecuentes los errores de etiquetado en los conjuntos de datos de machine learning?
Un estudio de NeurIPS 2021 de Northcutt et al. estima de media al menos un 3,3 % de errores de etiquetado en 10 conjuntos de prueba muy utilizados, y al menos el 6 % del conjunto de validación de ImageNet está mal etiquetado.
¿Cuánto se tarda en trazar una caja delimitadora?
Unos 35 segundos para una caja de calidad trazada de forma tradicional, y unos 7 segundos con el método «extreme clicking» (Papadopoulos et al., ICCV 2017).
¿Cuánto tarda la anotación por segmentación?
Una máscara de segmentación de instancias lleva unos 79 segundos por objeto según COCO (más de 22 horas de trabajo por cada 1.000 máscaras). La anotación completa a nivel de píxel de una escena urbana compleja llevó más de 1,5 horas por imagen en Cityscapes.
¿La preanotación acelera el etiquetado?
Sí. La segmentación asistida por modelo produjo máscaras unas 3 veces más rápido que el trazado manual de polígonos en un estudio con 2,5 millones de máscaras (Benenson et al., CVPR 2019). La revisión humana sigue siendo necesaria para corregir los errores del modelo.
¿Qué dice la Ley de IA de la UE sobre la anotación de datos de entrenamiento?
El artículo 10 exige que los conjuntos de datos de los sistemas de IA de alto riesgo sean pertinentes, suficientemente representativos y, en la mayor medida posible, sin errores y completos. Menciona expresamente la anotación y el etiquetado entre las operaciones de preparación de datos sujetas a una gobernanza adecuada.
¿Cuándo se aplican las obligaciones de alto riesgo de la Ley de IA?
A partir del 2 de diciembre de 2027 para los sistemas de alto riesgo del anexo III y del 2 de agosto de 2028 para los del anexo I, conforme al Ómnibus Digital sobre IA (Reglamento (UE) 2026/1744).