
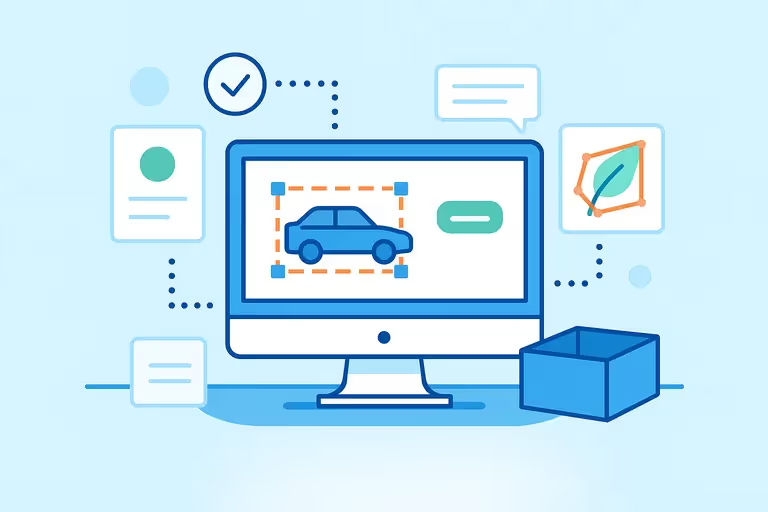

Datenlabeling-Dienste
DataVLab bietet Data-Labeling-Dienste für Machine-Learning-Teams, die konsistente, prüfbare Labels über alle Modalitäten hinweg benötigen: Bilder und Videos für Computer Vision, klinische und geschäftliche Texte für NLP, Sprache und Geräusche für Audiomodelle, LiDAR und Sensorströme für Perzeption sowie multimodale Datensätze, die diese kombinieren. Jedes Projekt läuft nach einer schriftlichen Labeling-Richtlinie, mit automatischem Pre-Labeling, wo es beschleunigt, und menschlicher Validierung jeder Charge. ISO/IEC-27001-zertifiziert, DSGVO- und HIPAA-konform, mit ausschließlich EU-basierten Labeling-Teams, wenn Daten Europa nicht verlassen dürfen.
Diese Seite beschreibt eine der zentralen Leistungsfamilien von DataVLab innerhalb unserer gemanagten Datenannotationsdienste.
Menschliche Validierung jeder Charge, mit Übereinstimmung pro Label und Gold-Set-Genauigkeit, die mit den Dateien berichtet werden.
ISO-27001-zertifiziert, DSGVO- und HIPAA-konform, auf Wunsch ausschließlich EU-Labeling-Teams.
Eine Richtlinie, ein QA-Prozess und ein Audit-Trail über Bild, Video, Text, Audio und Sensordaten hinweg.
Bilder: Klassifikation, Bounding Boxes, Polygone, Segmentierungsmasken, Keypoints und Attribute. Video: Objekt-Tracking, Aktions- und Event-Labels mit Zeitstempeln. Text und Dokumente: Dokumentklassifikation, Named Entities, Relationen, Sentiment und Intent, OCR-Felder und Layout. Audio: Transkription, Sprecher- und Geräuschereignis-Labels, Zeitstempel. 3D- und Sensordaten: Cuboids, Punktwolkensegmentierung und Multi-Sensor-Ausrichtung. LLM- und GenAI-Daten: Präferenz-Ranking, Antwortbewertung, Sicherheits- und Faktentreue-Labels. Für jeden Typ bauen wir das Label-Schema mit Ihnen auf: Klassendefinitionen, hierarchische Taxonomien, Regeln für Grenzfälle und die Beispiele, die Labeler vor dem ersten Element sehen.
Weiterführende Artikel: Was ist Datenlabeling? Klassen, Targets und Trainingsdatenqualität, Best Practices im Datenlabeling für zuverlässige Ground-Truth-Daten und Datenannotation vs. Datenlabeling: Was ist der Unterschied?.
Jedes Projekt beginnt mit einer schriftlichen Labeling-Richtlinie und einem vereinbarten Qualitätsziel, dann folgt ein bezahltes Pilotprojekt auf einer Stichprobe Ihrer echten Daten, damit Sie Labelqualität und Durchsatz sehen, bevor Sie Volumen beauftragen. Die Produktion kombiniert modellgestütztes Pre-Labeling, wo es hilft, mit Labelern, die auf Ihre Taxonomie geschult sind, auf einem kundenspezifischen Annotations-Tooling, das für Ihr Schema und Ihre Review-Schritte konfiguriert ist. Jede Charge durchläuft menschliche Validierung und automatische Konsistenzprüfungen (Klassenbalance, Duplikate und fehlende Elemente, Schemavalidität) vor der Lieferung.
Qualität wird gemessen, nicht angenommen: Inter-Annotator-Übereinstimmung pro Label, Genauigkeit gegen Gold-Elemente und Annahmestichproben bei jeder Charge, berichtet zusammen mit den Dateien. Lieferung in COCO, YOLO, Pascal VOC, JSONL, CSV oder Ihrem eigenen Schema, mit einem Audit-Trail, wer jedes Element gelabelt und wer es geprüft hat. Unser Preisleitfaden erklärt, wie Labeltyp, Volumen und Qualitätsniveau die Kosten bestimmen.
DataVLab ist nach ISO/IEC 27001 zertifiziert und arbeitet mit DSGVO- und HIPAA-konformen Workflows: zugangskontrollierte Labeling-Umgebungen, Datenminimierung, unterzeichnete Auftragsverarbeitungsverträge und ausschließlich EU-basierte Teams, wenn Ihre Daten Europa nicht verlassen dürfen. Personenbezogene, klinische und Finanzdaten können nach projektspezifischen Regeln verarbeitet werden, einschließlich Pseudonymisierung und Queues mit beschränktem Zugriff.
Für Hochrisiko-KI-Systeme nach dem EU AI Act dokumentieren wir Labeling-Richtlinien, Labeler-Qualifikationen, Qualitätsprüfungen und Datensatzzusammensetzung, damit Ihre Data-Governance-Unterlagen nach Artikel 10 vor den Fristen bereitstehen. Siehe unsere EU-AI-Act-Compliance-Checkliste.
Labelqualität entscheidet über Modellqualität. Eine Untersuchung von zehn weit verbreiteten Benchmark-Datensätzen fand mindestens 3,3 % fehlerhafte Labels und zeigte, dass deren Korrektur ändern kann, welches Modell am besten abschneidet. Ein Label ist in Sekunden gesetzt; ein unentdeckter Fehler kostet weit mehr, sobald er das Training erreicht, und noch mehr, sobald das Modell produktiv ist. Deshalb ist menschliche Validierung Teil jedes DataVLab-Labeling-Projekts und kein Zusatz. Unsere Datenannotation-Statistiken fassen die veröffentlichten Zahlen zusammen.
Data-Labeling-Dienste nach Datentyp
Vom Pilotdatensatz bis zum mehrjährigen Labeling-Programm gestalten wir den Workflow rund um Ihr Modellziel, Ihr Label-Schema, Ihre Grenzfälle und Ihre Compliance-Anforderungen.

Bild- und Video-Labeling

Klassifikation, Boxen, Masken, Keypoints und Tracks für Vision-Modelle
Labels für Detektion, Segmentierung, Klassifikation und Tracking über Handels-, Medizin-, Industrie-, Mobilitäts-, Landwirtschafts- und Geodaten-Bilder hinweg, mit IoU und Übereinstimmung pro Klasse geprüft.
Text- und Dokumenten-Labeling
Entitäten, Klassen, Relationen und Felder für NLP und Dokumenten-KI
Dokumentklassifikation, Named-Entity- und Relationslabels, Sentiment und Intent, OCR-Felder und Layout, in mehreren Sprachen und mit pro Label verfolgter Übereinstimmung.
Audio- und Sprach-Labeling
Transkripte, Sprecherwechsel und Geräuschereignisse mit Zeitstempeln
Wörtliche oder bereinigte Transkription, Sprecheridentifikation, Geräuschereignis- und Akustikszenen-Labels, mit Regeln zur Zeitstempelgenauigkeit und mehrsprachigen Labelern.
3D- und Sensordaten-Labeling
Cuboids, Punktwolkensegmentierung und Multi-Sensor-Ausrichtung
LiDAR, Radar, Tiefe und Telemetrie synchron zu Kameradaten gelabelt für ADAS, Robotik, Geodaten und industrielle Perzeption, mit gegen die Kalibrierung geprüfter Geometrie.
LLM- und GenAI-Daten-Labeling
Präferenz-, Bewertungs-, Sicherheits- und Faktentreue-Labels für Training und Evaluation
Präferenz-Ranking, Antwortbewertung nach Rubriken, Sicherheits- und Richtlinienlabels sowie Evaluationssets von Fachexperten, mit kalibrierten Bewertern und pro Kriterium berichteter Übereinstimmung.
Datensatz-QA und Relabeling
Audits, Gold-Sets und Korrekturen bestehender gelabelter Datensätze
Wir prüfen gelabelte Datensätze gegen Ihre Richtlinie, schätzen die Fehlerrate pro Label und labeln neu, was durchfällt, damit ein bestehender Datensatz vor dem Retraining vertrauenswürdig ist.
Entdecken Sie, wie unser Prozess funktioniert

Projekt definieren
Pilotannotation und Kalibrierung
Annotation
Prüfung und Qualitätssicherung
Lieferung
Datenannotation für spezialisierte KI-Anwendungen
Wir unterstützen Teams aus verschiedenen Branchen mit qualitätsgesicherten Trainingsdaten, die auf ihre Datenquellen, Modellziele und operativen Anforderungen abgestimmt sind.
Verbessern Sie die Leistung Ihrer KI
Wir bieten hochwertige Annotationsdienste, um die Leistung Ihrer KI zu verbessern

Annotation und Labeling für KI
Schöpfen Sie das volle Potenzial Ihrer KI-Anwendung mit unserer Experten-Datenlabeling-Technologie aus. Wir gewährleisten hochwertige Annotationen, die Ihre Projektlaufzeiten beschleunigen.
Datenannotationsdienste
ISO-27001-zertifizierte Datenannotationsdienste für Bild-, Video-, Dokument- und 3D-Daten, mit fachkundiger menschlicher Validierung und EU-basierten Teams für sensible Projekte.
Bildannotationsdienste
Bildannotationsdienste für Detektions-, Segmentierungs-, Keypoint-, OCR- und Klassifikationsmodelle. Bounding Boxes, Polygone, Masken und Landmarken mit menschlicher Validierung jeder Charge, ISO-27001-zertifiziert, auf Wunsch ausschließlich EU-Teams.
Videoannotationsdienste
Videoannotationsdienste für Detektions-, Tracking-, Aktionserkennungs- und Event-Modelle. Boxen, Masken und Keypoints pro Frame sowie identitätskonsistente Tracks mit menschlicher Validierung jeder Charge auf Sequenzebene. ISO 27001, auf Wunsch ausschließlich EU-Teams.
NLP-Datenannotationsdienste
Hochwertige NLP-Annotation für Intent-Erkennung, Entitätsextraktion, Textklassifikation, Sentimentanalyse und Konversations-KI.


Qualitätsgesicherte Annotation für leistungsstarke KI-Modelle

Bis zu 10x schneller
Beschleunigen Sie Ihr KI-Training mit High-Speed-Annotationen, die herkömmliche Prozesse deutlich übertreffen.

KI-unterstützt
Nahtlose Verbindung von menschlichem Fachwissen und KI-gestützter Präzision für höchste Annotationsqualität.

Fortgeschrittene Qualitätssicherung
Individuelle Qualitätskontrollen zur Sicherstellung präziser Annotationen – projektbasiert und zuverlässig.

Hochspezialisiert
Arbeiten Sie mit branchenerfahrenen Annotatoren zusammen, die ihr branchenspezifisches Know-how gezielt in Ihre Datenprojekte einbringen.

Ethisches Outsourcing
Verantwortungsvolle Arbeitsbedingungen und transparente Prozesse für qualitativ hochwertige Annotationen.

Bewährtes Fachwissen
Nachgewiesene Erfolge in verschiedenen Branchen – wir liefern zuverlässige, effektive Trainingsdaten für Ihre KI.

Skalierbare Lösungen
Von kleinen Datensätzen bis zu großflächigen KI-Projekten – wir skalieren Ihre Annotation nahtlos mit.

Globales Team
Ein weltweites Netzwerk aus erfahrenen Annotator:innen und KI-Expert:innen – für höchste Präzision und Effizienz.
Ihrer KI – noch heute.
Blog und Ressourcen
Lesen Sie unsere neuesten Artikel zu Datenannotation, Trainingsdaten, Qualitätssicherung, LLM-Evaluation und Best Practices für KI-Teams.
Nutzen Sie das volle Potenzial Ihrer KI – mit hochwertigen Trainingsdaten
Wir unterstützen Sie mit präziser Datenannotation, klaren Workflows und qualitätsgesicherten Trainingsdaten – damit Ihre KI-Modelle zuverlässiger, robuster und leistungsfähiger werden.