Statistiques de l'annotation de données 2026 : qualité des labels, effort et AI Act

Des chiffres vérifiés et sourcés sur l'annotation de données : fréquence des erreurs de labels, temps nécessaire pour une boîte, un masque ou une segmentation, ce qui accélère le travail, et ce que l'AI Act exige des données d'entraînement.
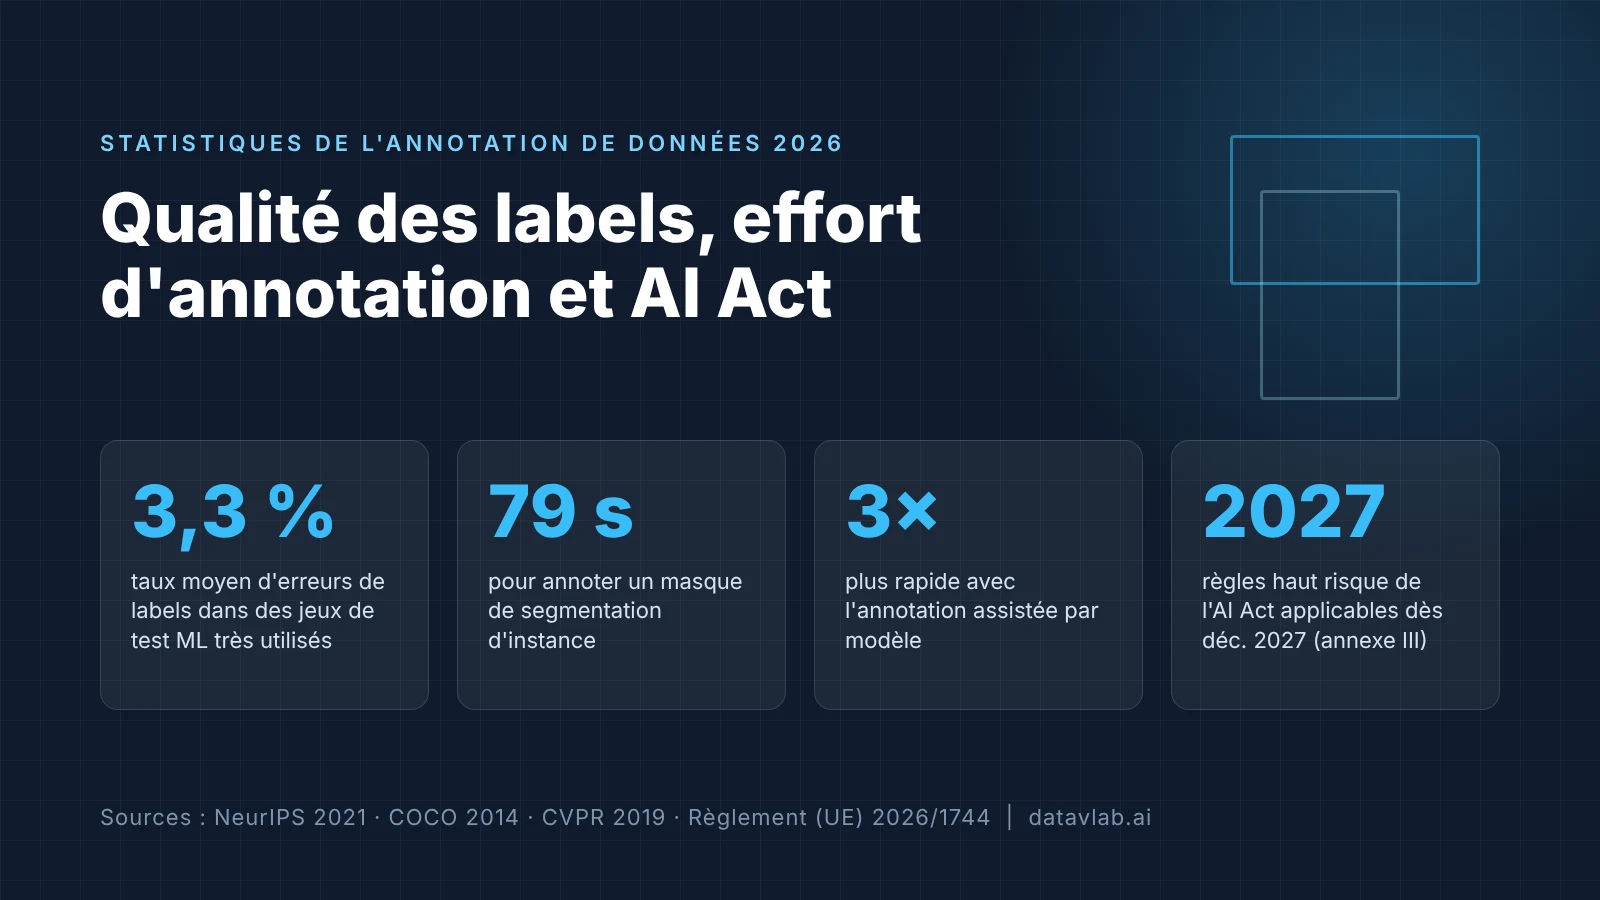
- Au moins 3,3 % des labels sont erronés en moyenne dans 10 jeux de test de machine learning très utilisés, et au moins 6 % du jeu de validation d'ImageNet est mal étiqueté.
- Une boîte englobante classique prend environ 35 secondes, un masque de segmentation d'instance environ 79 secondes, et l'annotation complète au pixel d'une scène urbaine plus de 1 h 30 par image.
- La segmentation assistée par modèle produit des masques environ 3 fois plus vite que le tracé manuel de polygones.
- L'article 10 de l'AI Act exige des données d'entraînement pertinentes, représentatives et autant que possible exemptes d'erreurs ; les obligations haut risque s'appliquent à partir du 2 décembre 2027 (annexe III) et du 2 août 2028 (annexe I).
Cette page rassemble des chiffres vérifiés et sourcés sur l'annotation de données : la fréquence des erreurs de labels, le temps nécessaire selon le type d'annotation, ce qui accélère le travail, et ce que l'AI Act exige désormais des données d'entraînement. Chaque chiffre renvoie à sa source d'origine. Il s'agit de statistiques du secteur, pas de tarifs DataVLab.
Les erreurs de labels sont fréquentes, même dans les jeux de référence
Au moins 3,3 % des labels sont erronés en moyenne dans 10 des jeux de test de machine learning les plus utilisés. L'étude couvre des jeux de données d'images, de texte et d'audio.
Au moins 6 % du jeu de validation d'ImageNet est mal étiqueté. ImageNet est l'un des benchmarks les plus cités en vision par ordinateur.
La qualité des labels peut changer le modèle gagnant
Sur des labels corrigés, ResNet-18 dépasse ResNet-50 dès que la part d'exemples de test initialement mal étiquetés augmente de seulement 6 %. Autrement dit, un modèle plus petit peut paraître moins bon qu'un plus gros uniquement parce que les labels de test sont bruités.
Conséquence pratique : une équipe qui choisit ses modèles sur des données de test non validées peut se tromper de modèle. La validation humaine des jeux d'évaluation compte autant que celle des données d'entraînement.
Source : Northcutt et al., NeurIPS 2021.
Combien de temps prend l'annotation, selon le type
Une boîte englobante de qualité prend environ 35 secondes à tracer avec la méthode classique. Avec une méthode optimisée appelée « extreme clicking », la même boîte prend environ 7 secondes, soit cinq fois plus vite (Papadopoulos et al., ICCV 2017).
Un masque de segmentation d'instance prend environ 79 secondes par objet. La construction du jeu COCO a nécessité plus de 22 heures de travail pour 1 000 segmentations (Lin et al., Microsoft COCO, 2014). C'est plus de deux fois le temps d'une boîte tracée classiquement, et plus de dix fois celui d'une boîte optimisée.
L'annotation complète au pixel d'une scène urbaine prend plus de 1 h 30 par image, contrôle qualité compris. L'annotation grossière des mêmes scènes a pris moins de 7 minutes par image, soit plus de 12 fois moins (Cordts et al., The Cityscapes Dataset, CVPR 2016).
À retenir pour planifier un projet : c'est le type d'annotation, et non le nombre d'images, qui détermine l'effort. Les mêmes 10 000 images peuvent représenter quelques jours ou plusieurs mois de travail selon qu'il faut des boîtes, des masques ou une segmentation dense. Notre guide des tarifs d'annotation de données explique comment cela se traduit en coût.
Où passe le temps, et ce qui l'accélère
Les professionnels de la donnée consacrent environ 38 % de leur temps à la préparation et au nettoyage des données, selon une enquête menée auprès de 3 493 répondants dans 133 pays (Anaconda, State of Data Science 2022).
La segmentation assistée par modèle produit des masques environ 3 fois plus vite que le tracé manuel de polygones : environ 34 secondes par objet contre environ 108 secondes estimées pour des polygones, mesuré sur 2,5 millions de masques (Benenson, Popov et Ferrari, « Large-scale interactive object segmentation with human annotators », CVPR 2019). Les estimations du temps de tracé manuel varient selon les études, d'environ 79 à 108 secondes par objet, en fonction de la complexité des objets.
C'est pourquoi les chaînes d'annotation modernes combinent pré-annotation automatique, correction et validation humaines : le modèle fait le premier passage, et les annotateurs se concentrent sur les cas qui demandent du jugement et sur les erreurs que les modèles laissent passer.
Ce que l'AI Act exige des données d'entraînement
L'article 10 du règlement européen sur l'IA (AI Act) exige que les jeux de données d'entraînement, de validation et de test des systèmes d'IA à haut risque soient « pertinents, suffisamment représentatifs et, dans toute la mesure du possible, exempts d'erreurs et complets au regard de la destination ».
L'article cite explicitement « l'annotation, l'étiquetage » parmi les opérations de préparation des données qui doivent faire l'objet de pratiques de gouvernance appropriées. Les fournisseurs doivent aussi examiner les jeux de données pour détecter d'éventuels biais, prendre des mesures pour les détecter, les prévenir et les atténuer, et identifier les lacunes des données qui empêchent la conformité.
Source : Commission européenne, AI Act Service Desk, article 10. Pour une approche pratique, consultez notre checklist de conformité à l'AI Act.
Quand les obligations haut risque s'appliquent
Les systèmes d'IA à haut risque listés à l'annexe III doivent être conformes à partir du 2 décembre 2027. L'IA à haut risque intégrée à des produits couverts par la législation européenne sur les produits (annexe I) doit l'être à partir du 2 août 2028.
Ces dates ont été fixées par l'Omnibus numérique sur l'IA, le règlement (UE) 2026/1744, publié au Journal officiel le 24 juillet 2026 et en vigueur depuis le 27 juillet 2026. Elles remplacent les échéances initiales d'août 2026 et d'août 2027. Les équipes qui développent des systèmes à haut risque disposent désormais d'une fenêtre précise pour mettre en place des pratiques de données conformes, y compris une annotation et un contrôle qualité documentés.
Source : synthèse de la publication du règlement (UE) 2026/1744 ; contexte de l'accord : Gibson Dunn.
Comment citer cette page
Vous pouvez réutiliser tout chiffre de cette page. Merci de citer la source d'origine indiquée à côté, et cette page ainsi : DataVLab, « Statistiques de l'annotation de données 2026 », https://datavlab.ai/fr/post/statistiques-annotation-donnees.
Transformer ces chiffres en un jeu de données fiable
DataVLab propose des services d'annotation de données pour les équipes des secteurs réglementés, en combinant pré-annotation automatique et validation humaine experte. Nous sommes certifiés ISO 27001 et conformes au RGPD et à HIPAA. Pour revoir les bases, lisez Qu'est-ce que l'annotation de données ?, ou contactez-nous pour parler de votre projet.
Les erreurs de labels sont-elles fréquentes dans les jeux de données de machine learning ?
Une étude NeurIPS 2021 de Northcutt et al. estime en moyenne au moins 3,3 % d'erreurs de labels dans 10 jeux de test très utilisés, et au moins 6 % du jeu de validation d'ImageNet est mal étiqueté.
Combien de temps faut-il pour tracer une boîte englobante ?
Environ 35 secondes pour une boîte de qualité tracée de façon classique, et environ 7 secondes avec la méthode « extreme clicking » (Papadopoulos et al., ICCV 2017).
Combien de temps prend l'annotation par segmentation ?
Un masque de segmentation d'instance prend environ 79 secondes par objet d'après COCO (plus de 22 heures de travail pour 1 000 masques). L'annotation complète au pixel d'une scène urbaine complexe a pris plus de 1 h 30 par image dans Cityscapes.
La pré-annotation accélère-t-elle l'étiquetage ?
Oui. La segmentation assistée par modèle a produit des masques environ 3 fois plus vite que le tracé manuel de polygones, dans une étude portant sur 2,5 millions de masques (Benenson et al., CVPR 2019). Une revue humaine reste nécessaire pour corriger les erreurs du modèle.
Que dit l'AI Act sur l'annotation des données d'entraînement ?
L'article 10 exige que les jeux de données des systèmes d'IA à haut risque soient pertinents, suffisamment représentatifs et, dans toute la mesure du possible, exempts d'erreurs et complets. Il cite explicitement l'annotation et l'étiquetage parmi les opérations de préparation des données soumises à une gouvernance appropriée.
Quand les obligations haut risque de l'AI Act s'appliquent-elles ?
À partir du 2 décembre 2027 pour les systèmes à haut risque de l'annexe III et du 2 août 2028 pour ceux de l'annexe I, en application de l'Omnibus numérique sur l'IA (règlement (UE) 2026/1744).